Visual Navigation Transformer (ViNT)
First page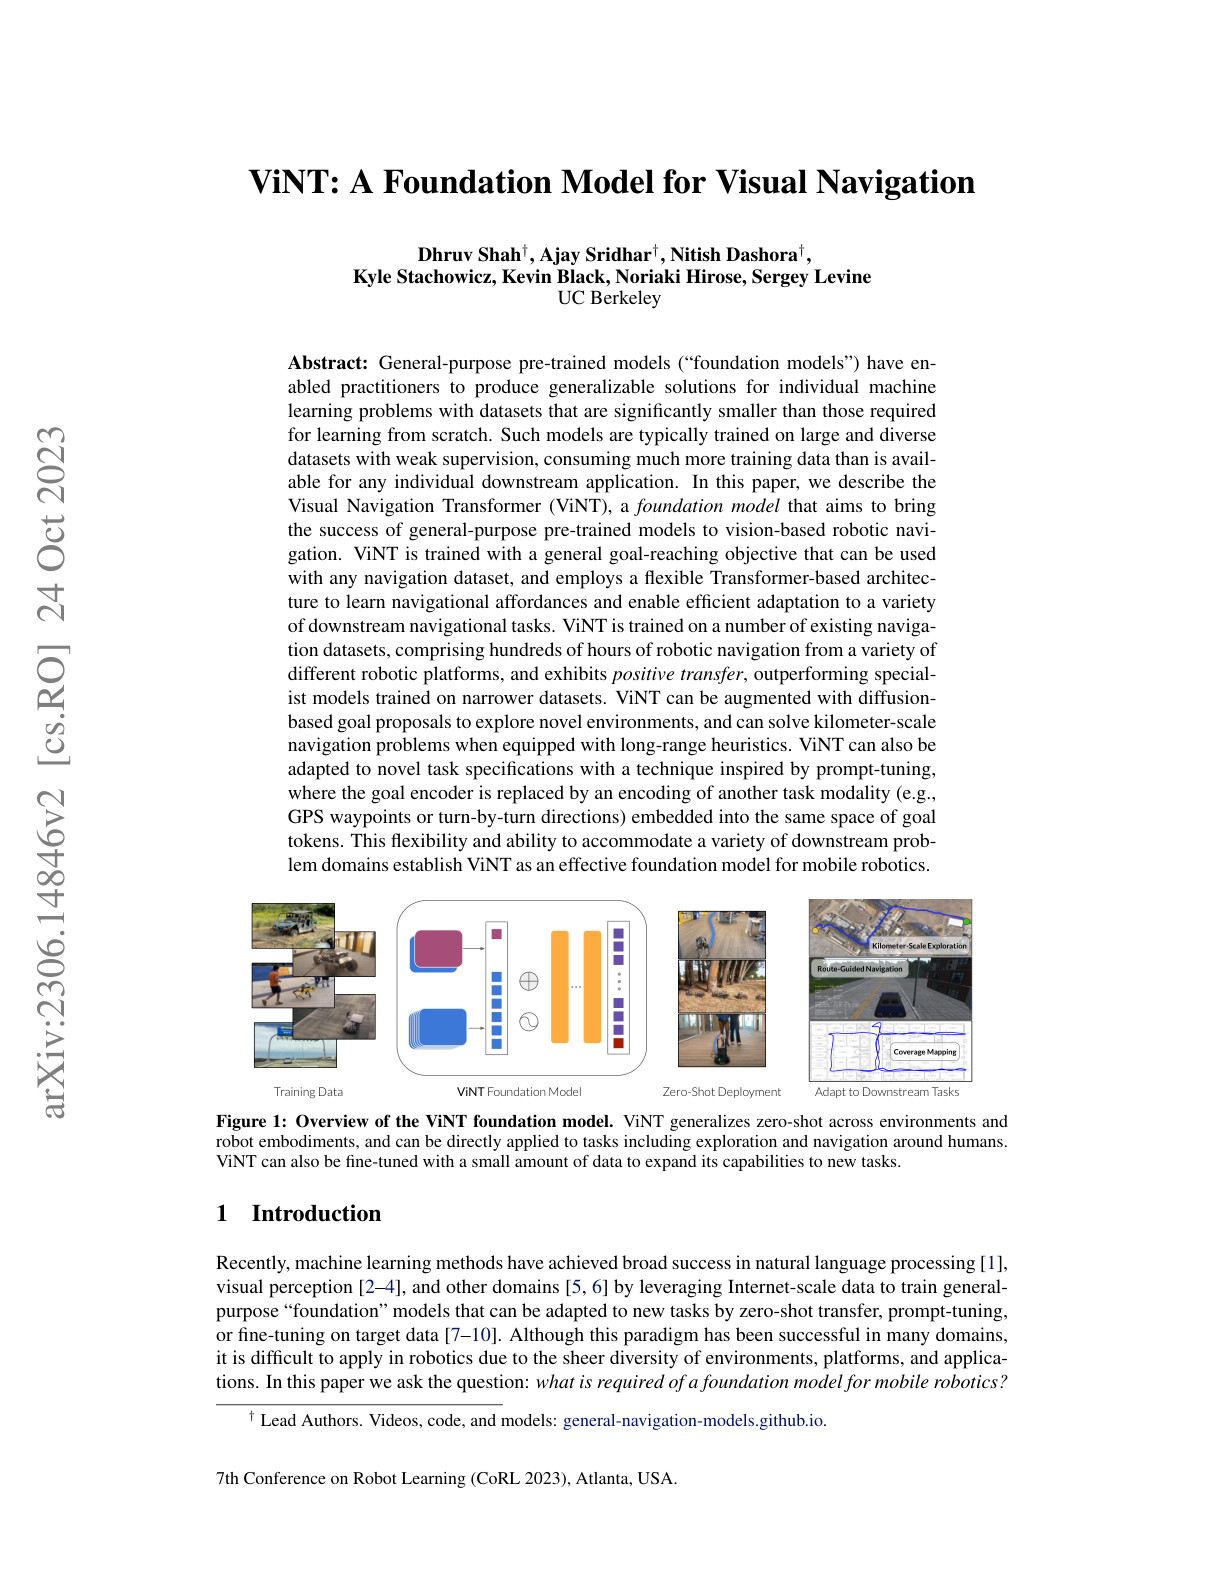
Paper summary
A foundation model for vision-based robotic navigation built on flexible Transformers.
Ask this paper
01
Cross-embodiment: Works across different robotic platforms (quadrupeds, wheeled robots, drones) without per-robot retraining.
02
Pretrained + fine-tuned: Leverages pretrained vision models and fine-tunes on navigation-specific data for strong transfer.
03
Multi-task navigation: Handles goal-reaching, exploration, and map-building within a single Transformer backbone.
04
Robotics foundation models: An early robotics-specific foundation model that preceded RT-2 and the VLA explosion of late 2023.