Smaller, Weaker, Yet Better
First page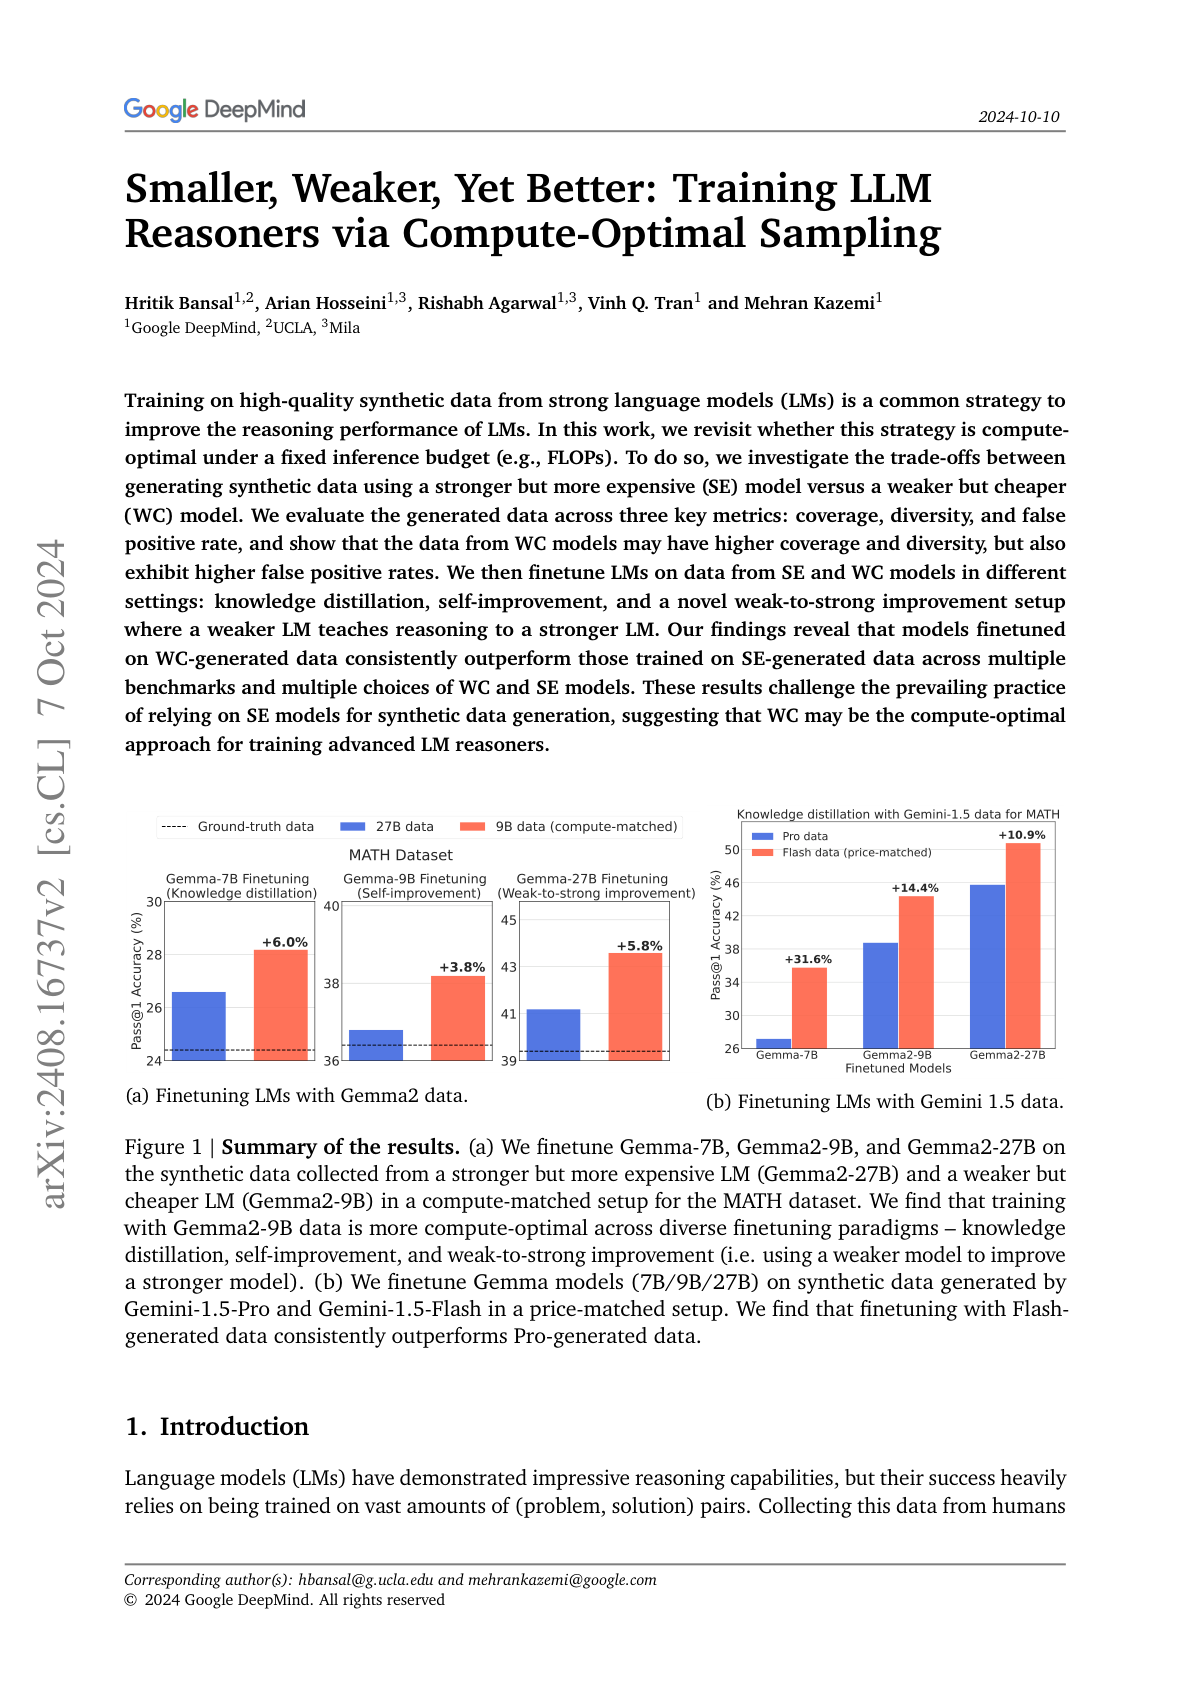
Paper summary
finds that weaker + cheaper (WC) models can generate better synthetic data for fine-tuning models compared to data generated with stronger but more expensive models; overall, results suggest that WC models may be a compute-optimal approach for training advanced LLM reasoners.