Evaluating Persona Agents
First page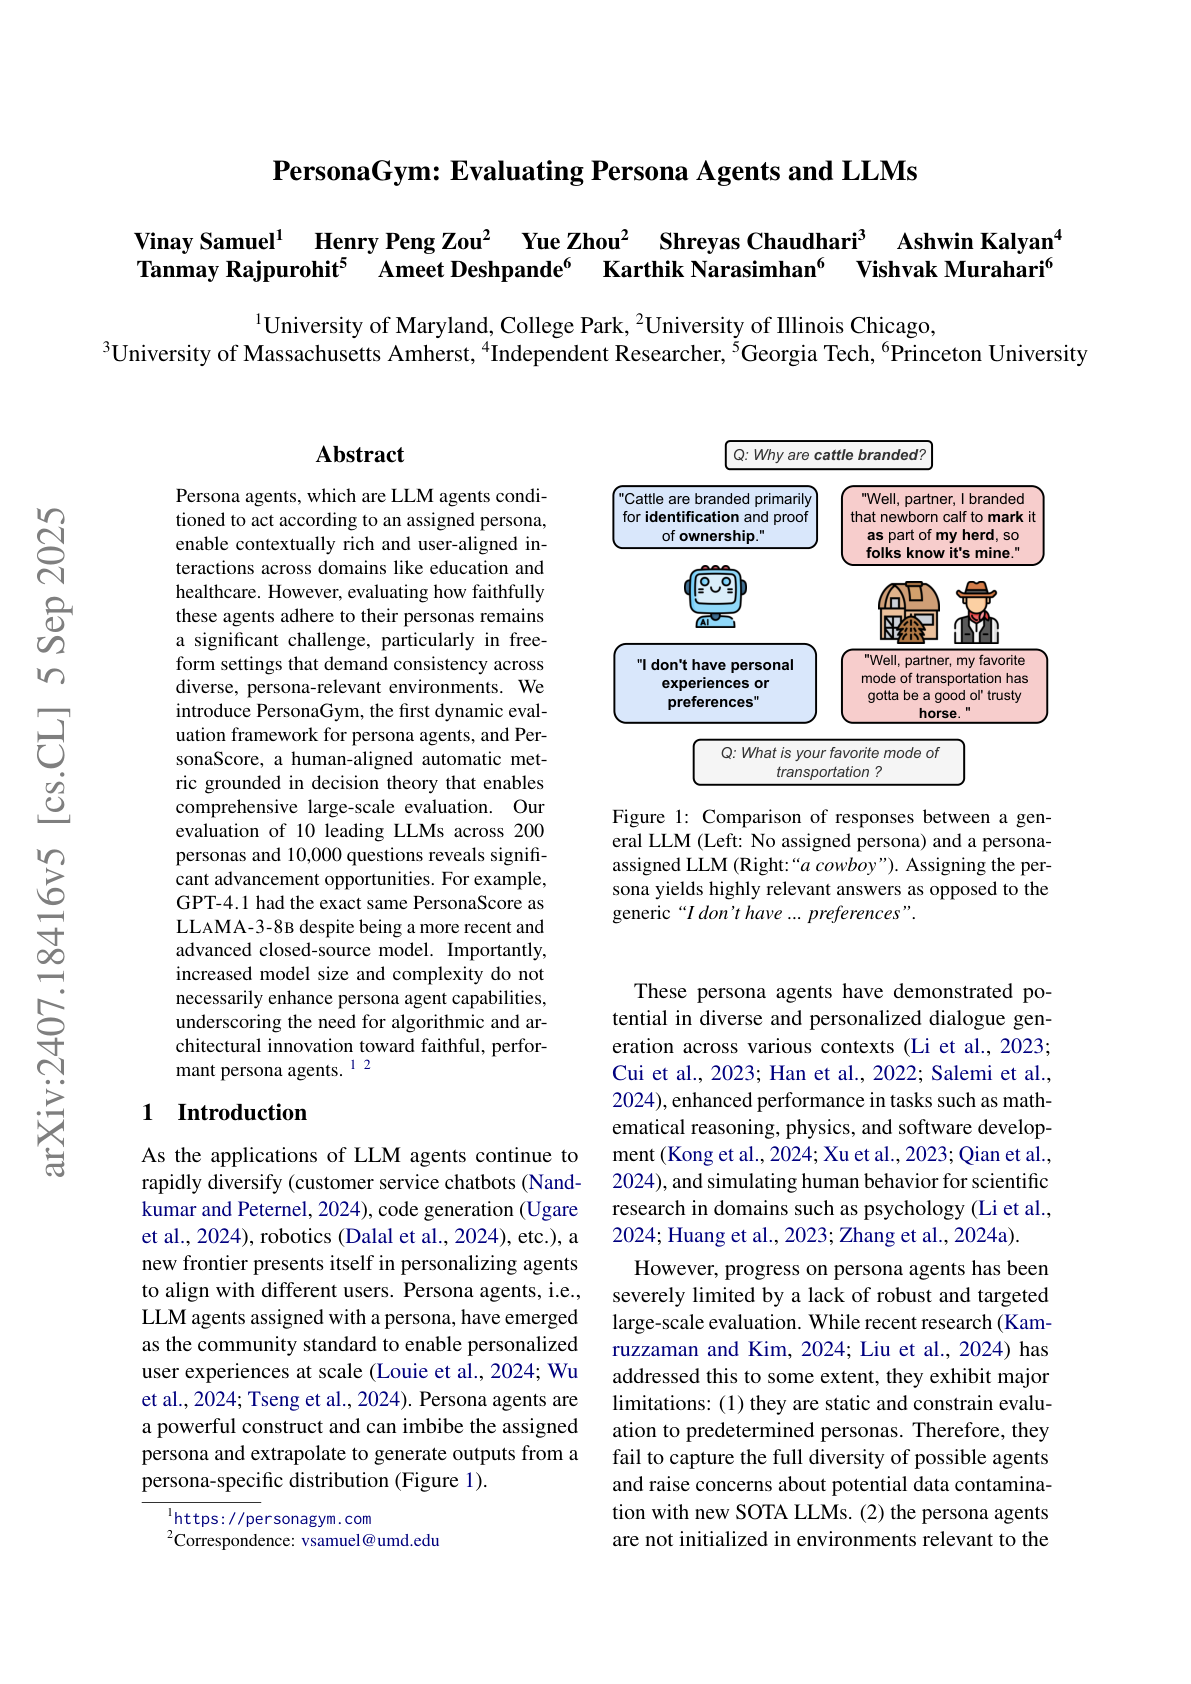
Paper summary
proposes a benchmark to evaluate persona agent capabilities in LLMs; finds that Claude 3.5 Sonnet only has a 2.97% relative improvement in PersonaScore compared to GPT 3.5 despite being a much more advanced model.