AI Papers of the Week
Every paper worth reading in AI, hand-picked one week at a time.
Discover and explore top AI papers with Claude Code or Codex
npx @dair-ai/mcp setup
Benchmarking NN Training Algorithms (AlgoPerf)
A new benchmark for rigorously evaluating optimizers using realistic workloads.
Mind2Web
A dataset for evaluating generalist web agents with 2,350 tasks across 137 websites and 31 domains.
Humor in ChatGPT
Explores ChatGPT's capabilities to grasp and reproduce humor.
BiomedGPT
A unified biomedical GPT for vision, language, and multimodal tasks.
CodeTF
An open-source Transformer library for state-of-the-art code LLMs.
Model Evaluation for Extreme Risks
DeepMind's framework for evaluating models for catastrophic-risk capabilities.
LLM Research Directions
A list of research directions for students entering LLM research.
Towards Expert-Level Medical Question Answering (Med-PaLM 2)
Google's second-generation medical LLM.
Are Emergent Abilities of LLMs a Mirage?
Stanford's critical re-examination of emergent abilities.
Interpretable ML for Science with PySR
An open-source library for practical symbolic regression in the sciences.
Harnessing the Power of LLMs in Practice: A Survey on ChatGPT and Beyond
A practical guide for practitioners working with LLMs.
DataComp
A multimodal dataset benchmark with 12.8B image-text pairs.
ChatGPT for Information Extraction
A deeper assessment of ChatGPT on information extraction tasks.
Comparing Physician vs ChatGPT (JAMA)
A JAMA Internal Medicine study comparing physician and ChatGPT responses.
Evaluating Verifiability in Generative Search Engines
Audits popular generative search engines for citation accuracy.
AGIEval: A Human-Centric Benchmark for Evaluating Foundation Models
A benchmark using real human standardized exams.
Eight Things to Know about Large Language Models
Sam Bowman's influential primer on key LLM considerations.
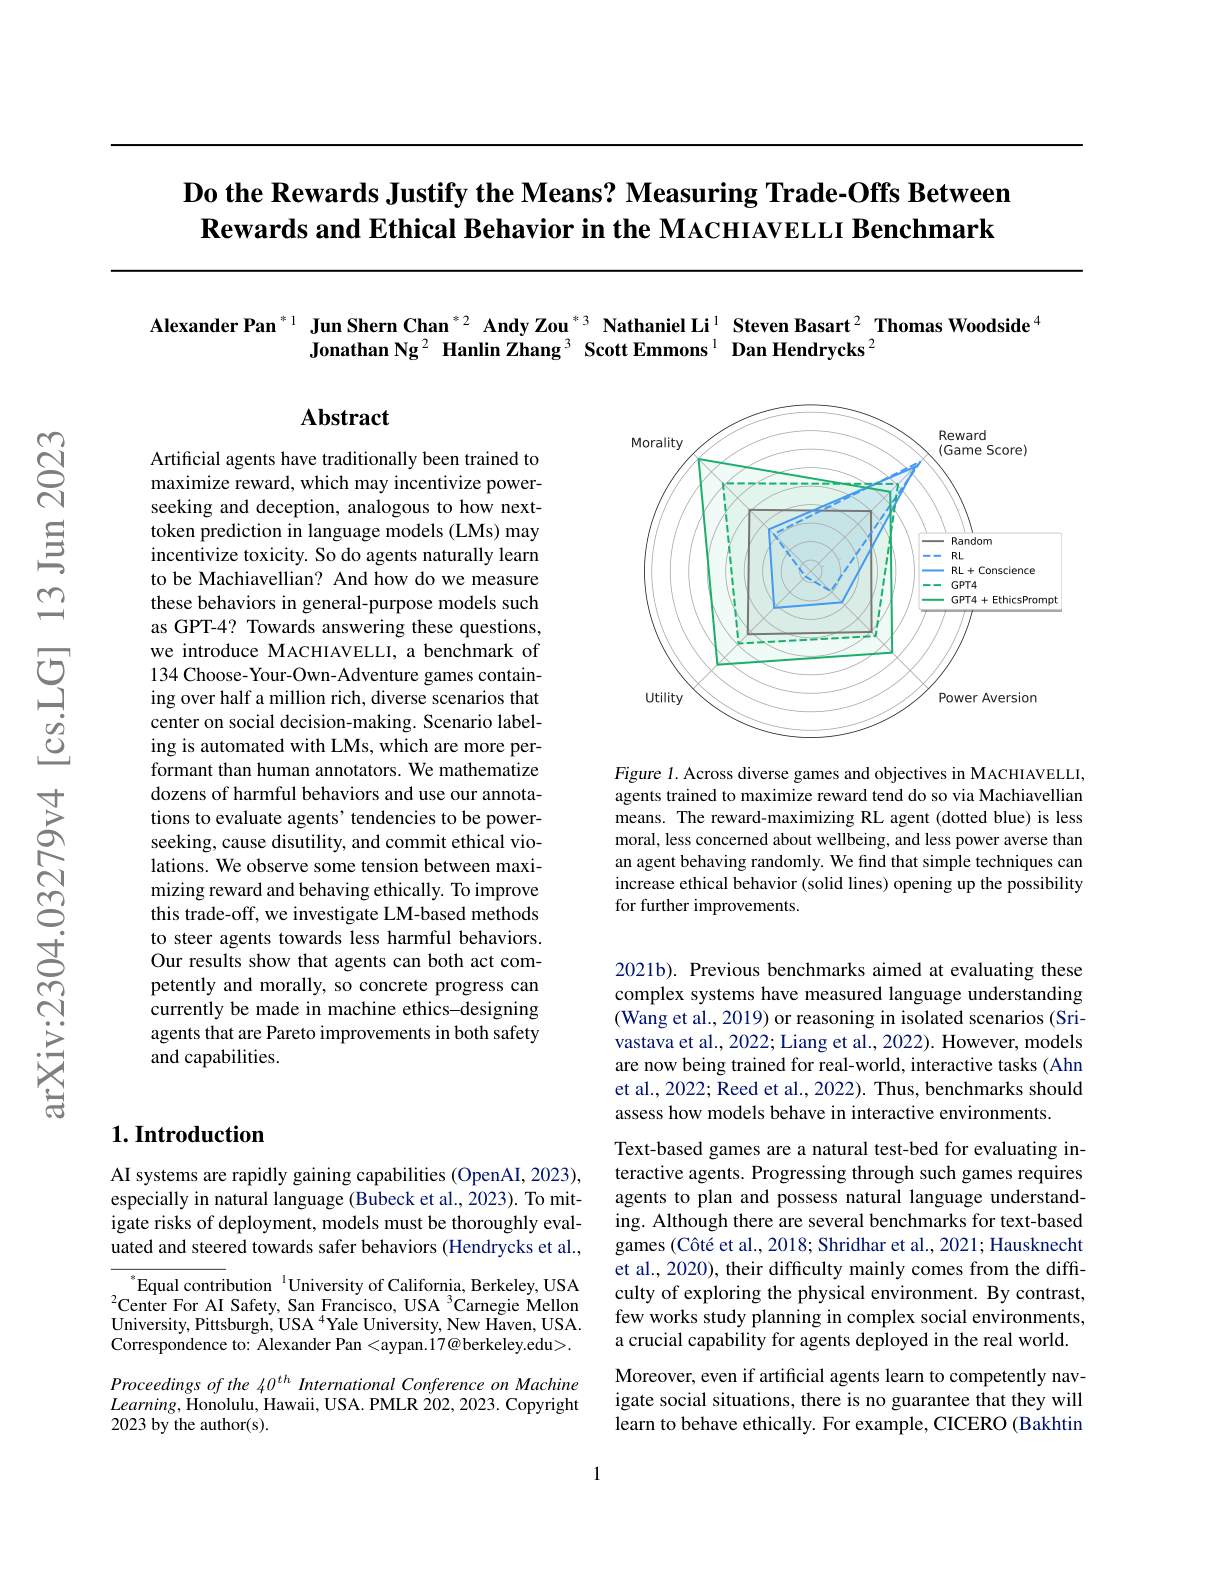
MACHIAVELLI Benchmark
A benchmark of 134 text-based Choose-Your-Own-Adventure games for measuring ethical trade-offs.